KI-MODELLE ENTDECKEN
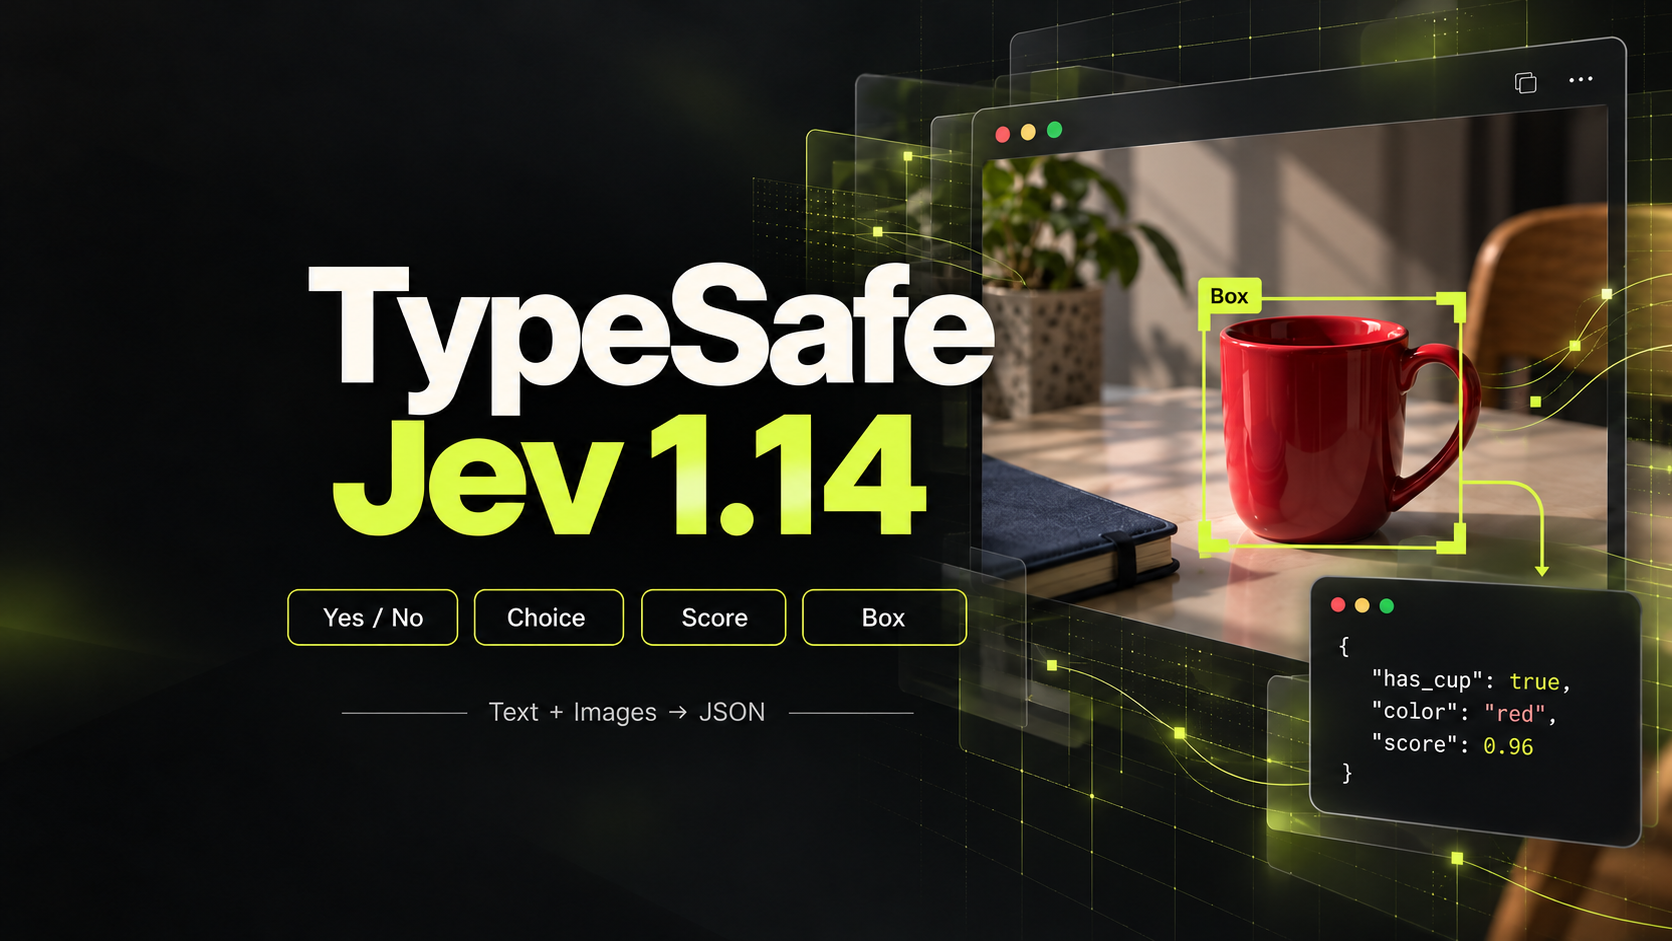
 TypeSafe
 Jev 1.14
Structured multimodal decisions from text, JSON, and inline images.
Finden Sie eine Video-zu-Video-API für Ihre Transformation
ANBIETER
 Black Forest Labs
 Grok
 Kling
 Lightricks
 OpenAI
 Runway
 SeeAPI
 Vidu






Veröffentlichungszeitleiste der Modelle
Wan 3.0 Prime
AlibabaAlibaba Wan 3.0 Prime Videogenerierung mit Text-, Bild-, Video-, Audio-, Dokument- und Webseitenreferenzen.
Wan 3.0
AlibabaAlibaba Wan 3.0 Videogenerierung mit Text-, Bild-, Video-, Audio-, Dokument- und Webseitenreferenzen.
Gemini Omni Flash 1.1
GoogleGemini Omni Flash 1.1 video generation with image, video, audio, and character references.
Seedance 2.5
ByteDanceByteDances Videomodell der nächsten Generation für längere Erzählungen mit bis zu 50 multimodalen Referenzen
MiniMax H3
MiniMaxMultimodale Videoerstellung mit nativem Audio durch MiniMax H3 (Hailuo 03), mit Ausgabe bis zu 2K.
Seedance 2.0 Mini
ByteDanceKosteneffizientes Seedance-2.0-Videomodell von ByteDance für schnellere Generierung und geringere Inferenzkosten
Seedance 2.0 Fast
ByteDanceSchnelles & erschwingliches multimodales Video mit Text-, Bild-, Video- und Audio-Eingaben bis zu 720p
Wan 2.7
AlibabaAlibabas Wan 2.7 Video-API unterstützt vollständige Modalitätseingaben (Text, Bild, Video, Audio) für vier Modi (T2V, I2V, Reference2V, Edit) und liefert Ausgaben in 720P–1080P.
HappyHorse 1.0
AlibabaHappyHorse Video unterstützt Text-zu-Video, Bild-zu-Video, Referenz-zu-Video und Videobearbeitung und liefert 720P–1080P-Ausgaben mit bis zu 15 Sekunden Länge.
PixVerse V6
PixVerseFilmische Videogenerierung mit PixVerse V6, einschließlich Übergängen, Referenzen, Videoverlängerung und nativem Audio.
Ein bestehendes Video gezielt transformieren
Eine Video-zu-Video-API nutzt vorhandene Clips für Referenzgenerierung, Bearbeitung oder Verlängerung. Wählen Sie zuerst den benötigten Vorgang. Nicht jedes Modell unterstützt alle drei Möglichkeiten.
Änderungsabsicht festlegen
Eine Referenz lenkt eine neue Szene, eine Bearbeitung verändert vorhandene Inhalte, eine Verlängerung erzeugt die Fortsetzung. Prüfen Sie Identität, Bewegung und Übergänge im gesamten Ergebnis.
Quellclip und Ergebnis vergleichen
Prüfen Sie Kontinuität, Bewegung und relevante Details im ganzen Clip.
Dokumentierte Eingaben respektieren
Länge, Format und Steuerungen unterscheiden sich je Endpunkt.
Vom Quellclip zur Transformation
Prüfen Sie die Grenzen des Endpunkts vor der Integration.
Freigegebenes Video wählen
Nutzen Sie einen repräsentativen Clip mit wichtigen Merkmalen.
Transformation dokumentieren
Lesen Sie Eingabefelder, Ausgabeoptionen und Limits.
Konsistenz testen
Führen Sie einen autorisierten Test durch und bewerten Sie den Clip.
Video-zu-Video-API: Häufige Fragen
Hinweise zu Quellclips und Transformationen.
Ein vorhandener Clip dient als Eingabe für ein neues Videoergebnis. Ob Referenzgenerierung, Bearbeitung oder Verlängerung möglich ist, hängt vom gewählten Endpunkt ab.